-
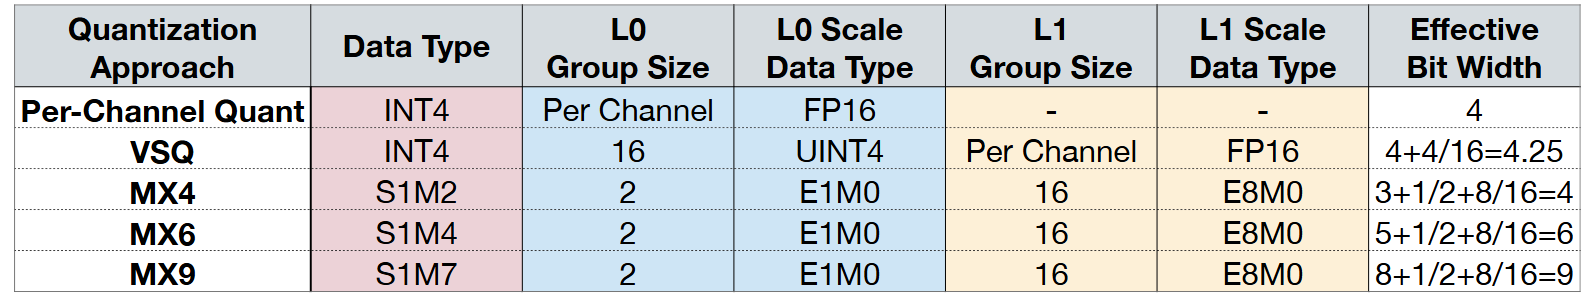
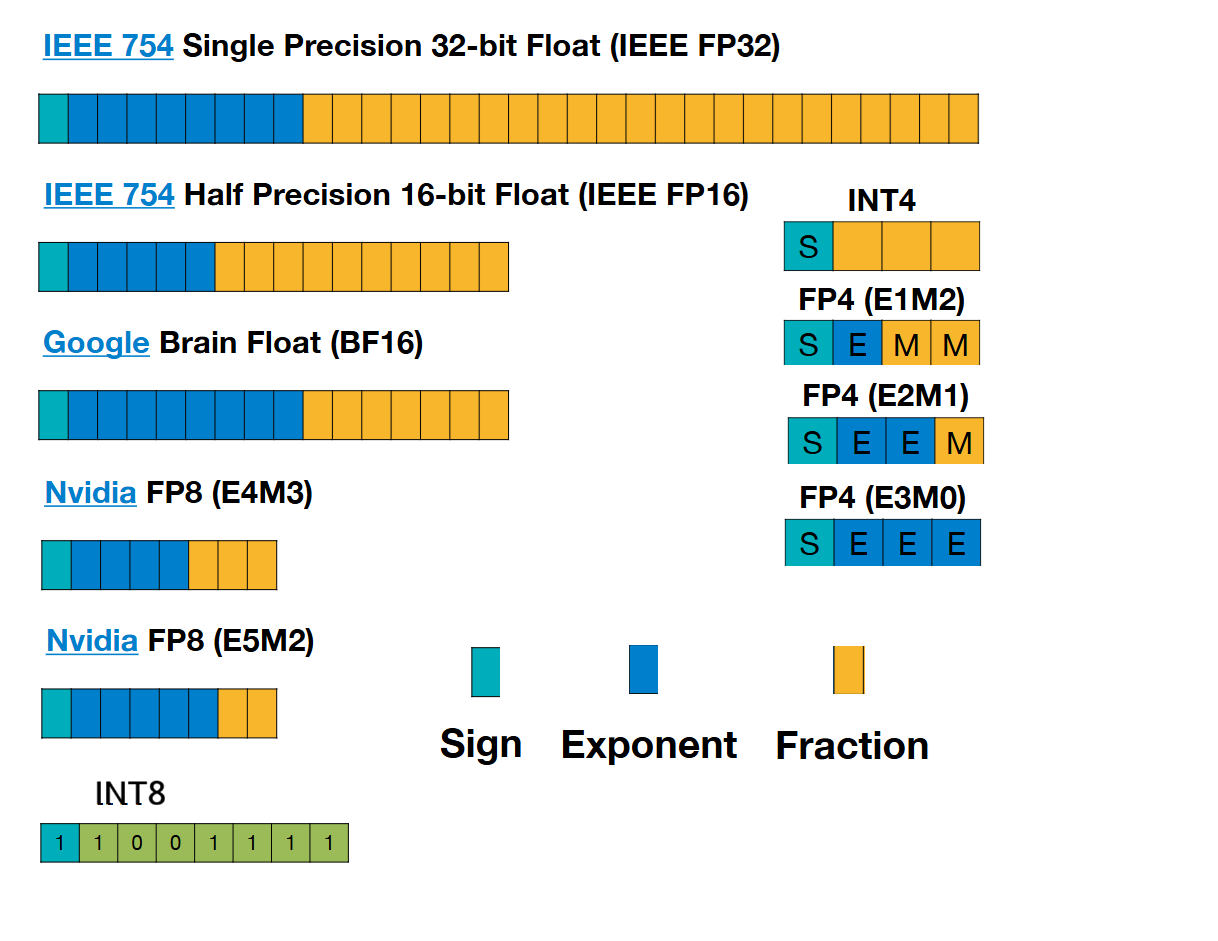
数值数据类型
-
量化方法
- K-Means量化
- 霍夫曼编码
- 线性量化
- 线性量化矩阵乘法
-
后训练量化
- 量化粒度
- 动态范围裁剪
- 舍入
- 量化感知训练
- 三元量化
- 混合精度量化
数据数值类型
量化方法
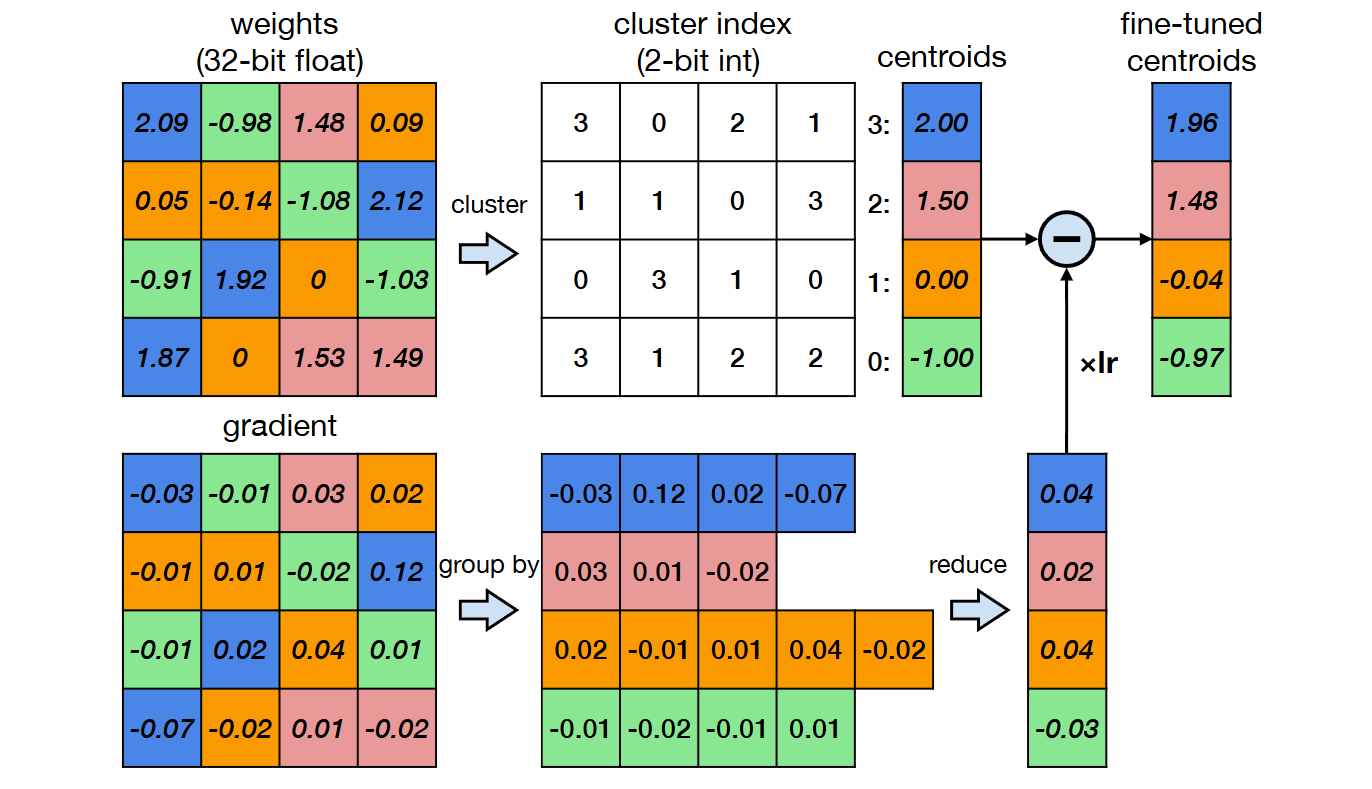
将相近的权重分组映射到低精度编码,在使用权重时根据码本还原原精度权重,训练时把相同颜色的梯度进行规约操作,更新权重。
对频繁使用的权重使用低精度
对不常使用的权重使用高精度
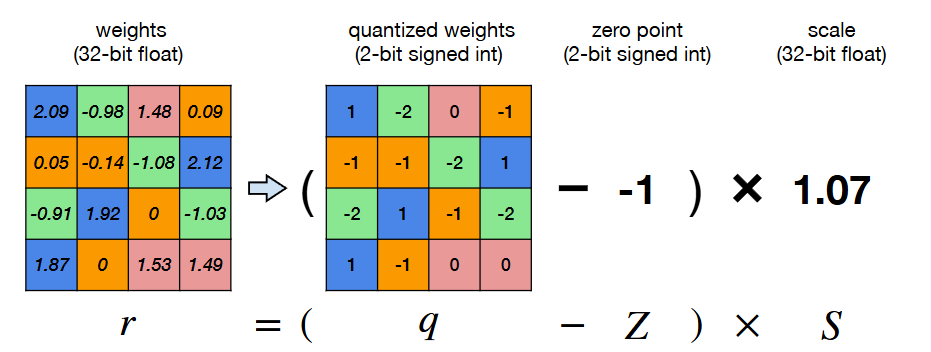
qmin=−2N−1,qmax=2N−1−1
其中
N=bit位数
S=qmax−qminrmax−rmin
Z=round(qmin−Srmin)
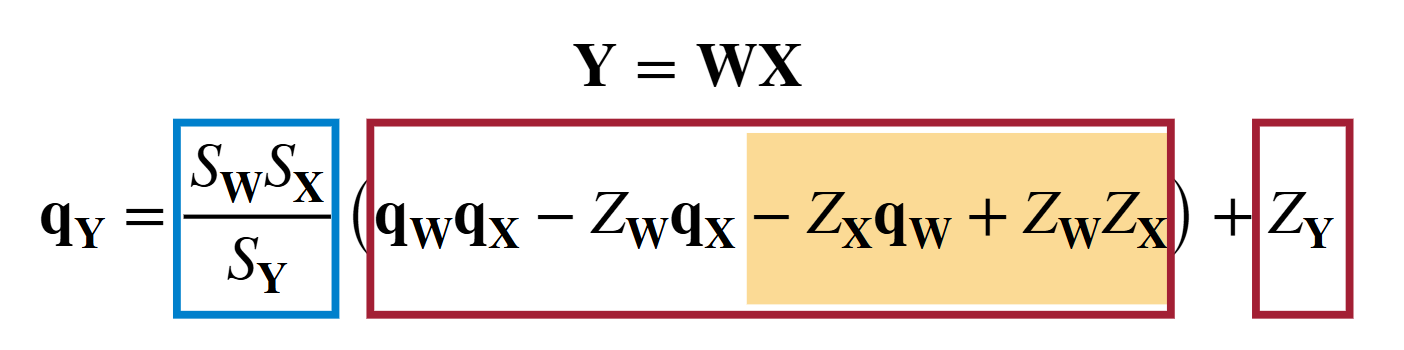
略过简单的推导过程,直接考虑计算方法。
由于ZW服从正态分布,且均值为0,因此直接忽略带ZW的项。
qY=SYSWSX(qWqX−ZXqW)+ZY
SYSWSX根据已有的研究表明,可以表示为2−nM0, where M0∈[0.5,1]。这可以通过定点数和位移操作计算,开销很小。
ZXqW这部分都可以预先进行计算,因此没有运行时开销。
ZY是低精度整数加法。
qWqX是整数乘法。
后训练量化
量化粒度
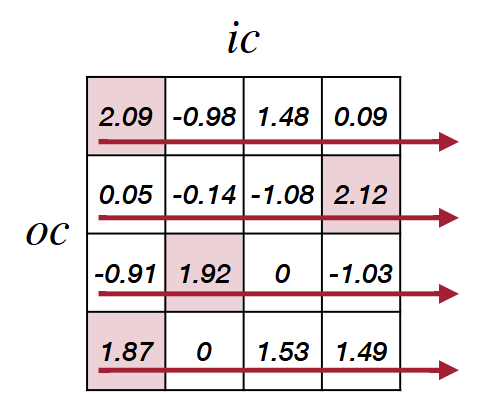
在每个张量上使用独立的S来量化。不同输出通道的权重范围差异很大(可能超过100倍),这会导致异常权重(outlier weight)的出现。这种大范围的差异使得使用单一缩放因子进行量化时,难以同时保持所有权重的准确性。
用于激活量化的动态范围裁剪
之前的rmax,rmin受到极端值影响很大,如果数据分布如下图,
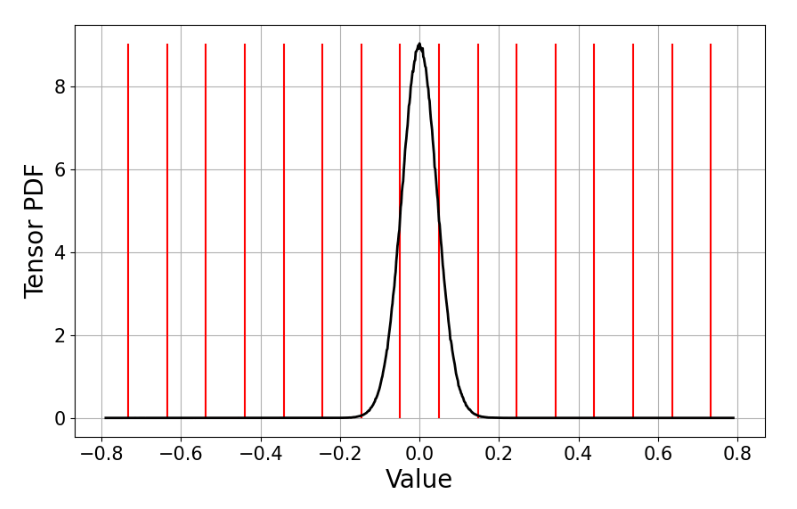
大部分数据的近似都将有很大误差。因此我们使用以下方法去除噪声。
r^max,min(t)=α⋅rmax,min(t)+(1−α)⋅r^max,min(t−1)
α越大我们就越倾向于使用最近的动态范围。如果模型不是我们训练的,就不能使用这个方法。
- 通过在训练好的浮点32位(FP32)模型上运行一些样本来进行校准
如果输入严格遵循拉普拉斯分布,
min∣r∣maxE[(X−Q(X))2]
拉普拉斯分布(0,b),对于2、3、4位量化,最优的 ∣r∣max 分别为 2.83b,3.89b,5.03b,参数 b 可以通过校准输入数据的分布来估计。
信息损失是通过KL散度来表征的,类似交叉熵损失。
DKL(P∣∣Q)=N∑LP(xi)logQ(xi)P(xi)
-
- 基于Newton-Raphson方法最小化均方误差(MSE)
MSE:
E(θ)=n1i=1∑n(yi−f(xi;θ))2
Newton-Raphson方法:
θk+1=θk−Hk−1∇E(θk)
∇E:
∇E(θ)=−n2i=1∑n(yi−f(xi;θ))∇f(xi;θ)
H:
∇2E(θ)=n2i=1∑n(∇f(xi;θ)∇f(xi;θ)T+(yi−f(xi;θ))∇2f(xi;θ))
舍入
四舍五入并不是最佳选择,每个权重的最佳舍入并不是整个张量的最佳舍入,我们采用基于学习的方法。
argminV∥Wx−[[W]+h(V)]x∥F2+λfreg(V)
h()是类似sigmoid的映射到(0,1)的函数
V是与矩阵形状相同的随机变量
最后一项是正则化项,用来鼓励h(V)在(0,1)取二值
这样在四舍五入时加入一些随机性很有帮助。
量化感知训练
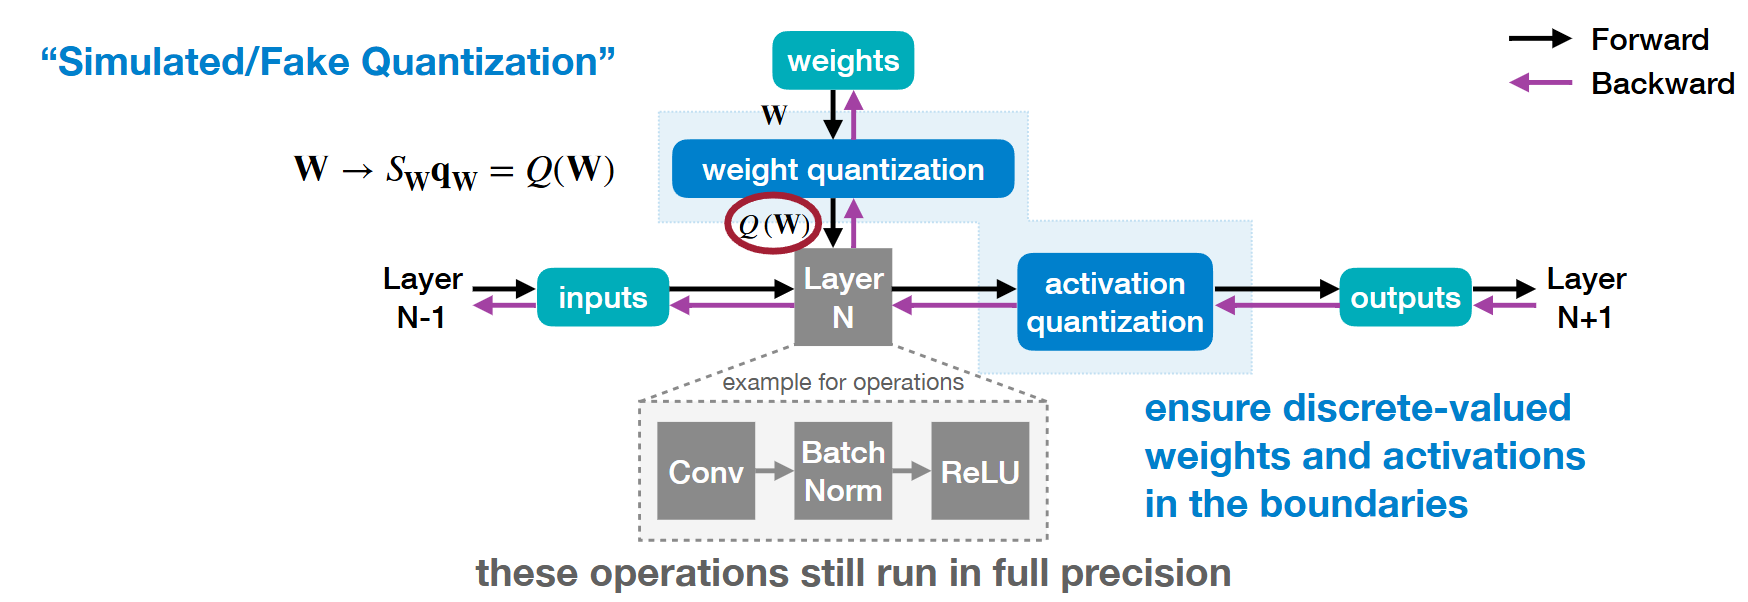 $$
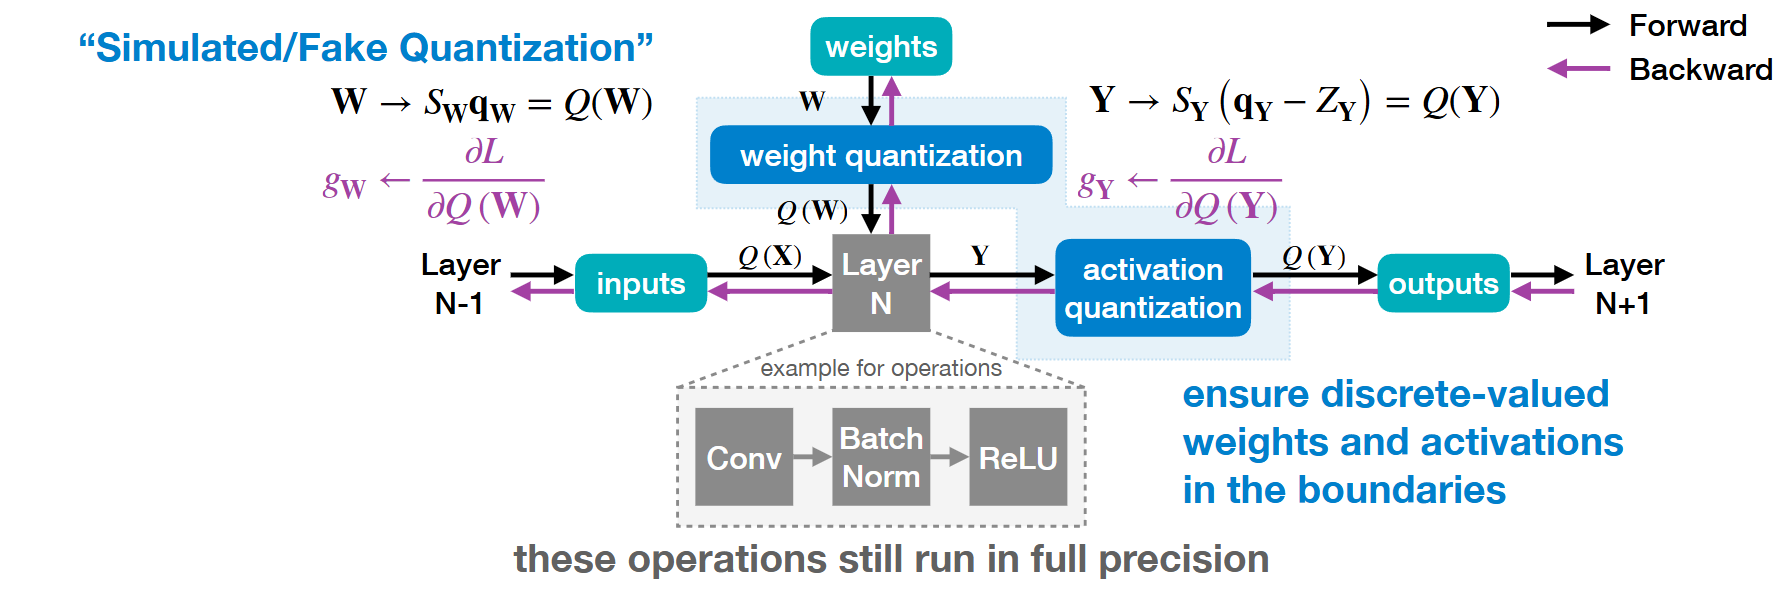
Y\rarr S_{Y}(q_{Y}- Z_{Y})=Q(Y)
$$
其中 $Q(Y)$ 是量化的输出矩阵
又称为模拟/伪量化,这是为了模拟量化环境,得到适应量化环境的模型。
在整个训练过程,我们一直维护一个原精度权重副本。这样我们就可以累积小梯度,提高模型精度。
但是Q()实际上是一个阶跃函数,
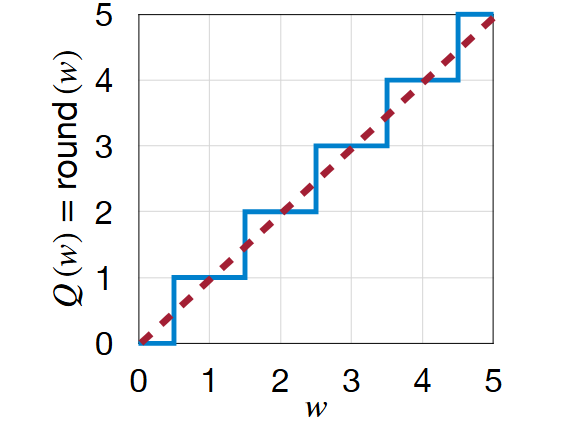
在反向传播的时候梯度全为0。因此我们要使用直通估计器(STE)。
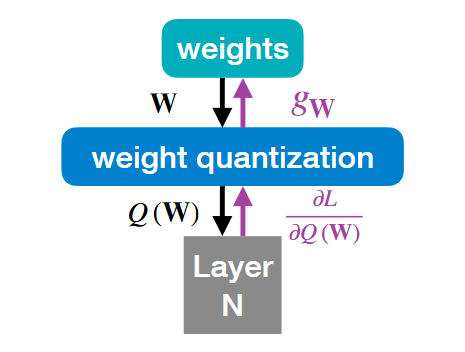 $$
g_{W}=\frac{\partial L}{\partial W}=\frac{\partial L}{\partial Q(W)}
$$
也就是直接对Q(W)求梯度,作用在原矩阵上。
三元量化
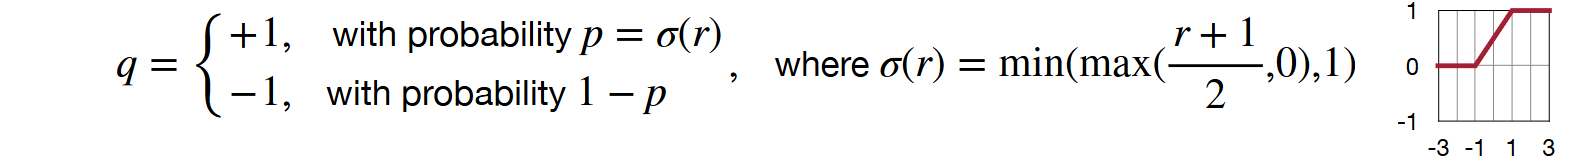
按照之前在量化中增加随机性的经验,我们根据r确定量化为1/-1的概率。
又根据之前的经验,我们使用αWB来让矩阵所有元素的和与原矩阵相等。其中α=n1∣∣W∣∣。
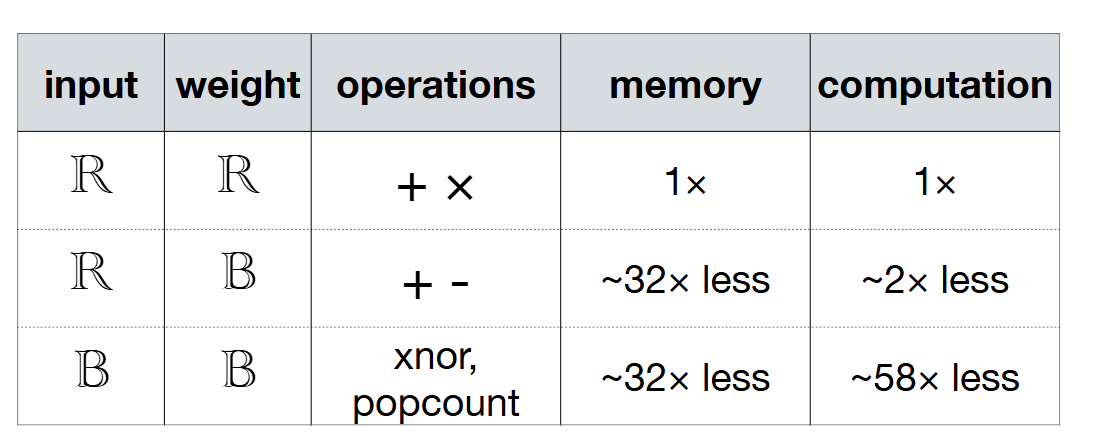
如果激活和权重全是二值化的,计算方法如下
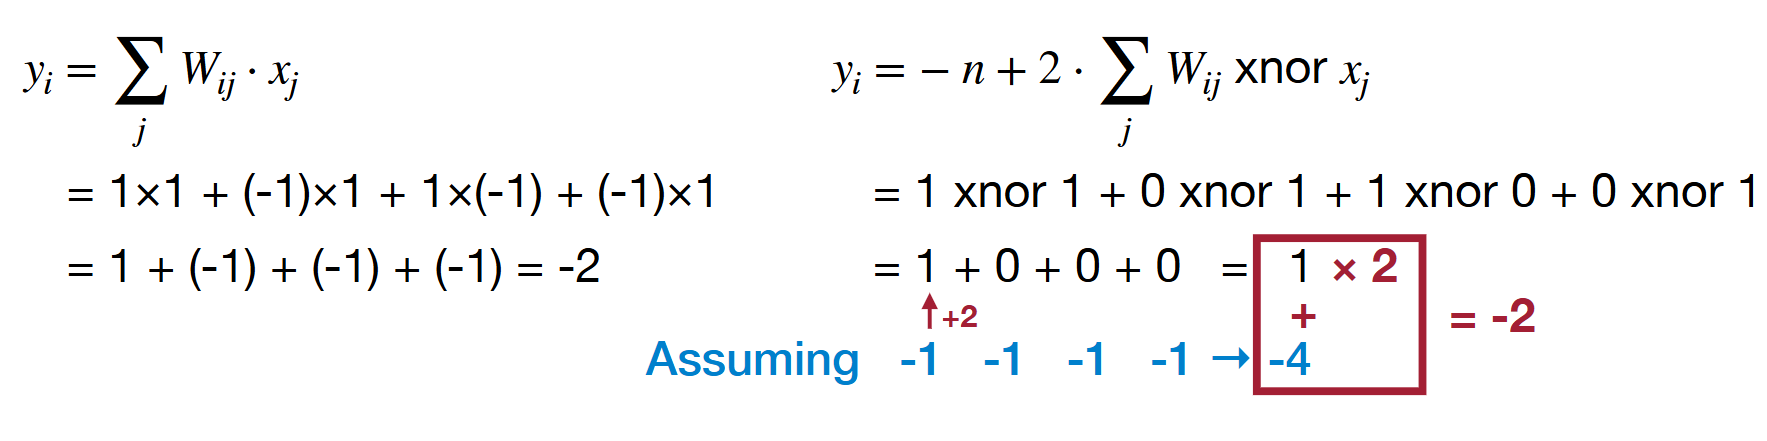
计算公式在图右上角。原理就是先假设符号全不相同,因为每有一个相同就差2,因此找出有几个相同再×2。这样计算开销极低。
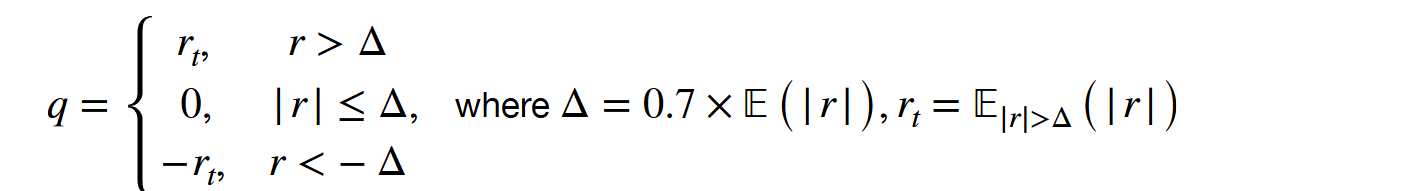
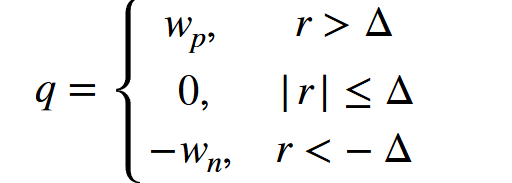 wp,wn是可学习的
混合精度量化
混合的搜索空间极大,所以也使用强化学习自动搜索。