
剪枝
-
剪枝简介
- 什么是剪枝
- 我们应该如何表述剪枝
-
剪枝粒度的抉择
- 我们应该以什么方式剪枝
-
剪枝标准的抉择
- 我们应该剪枝哪些权重/神经元
-
剪枝比例的抉择
- 每层的目标稀疏性
-
微调/训练剪枝神经网络
- 如何提高剪枝模型的性能
-
稀疏矩阵乘法
- 矩阵表示
- 矩阵乘法
- 其他优化方法
- 稀疏卷积算法
剪枝简介
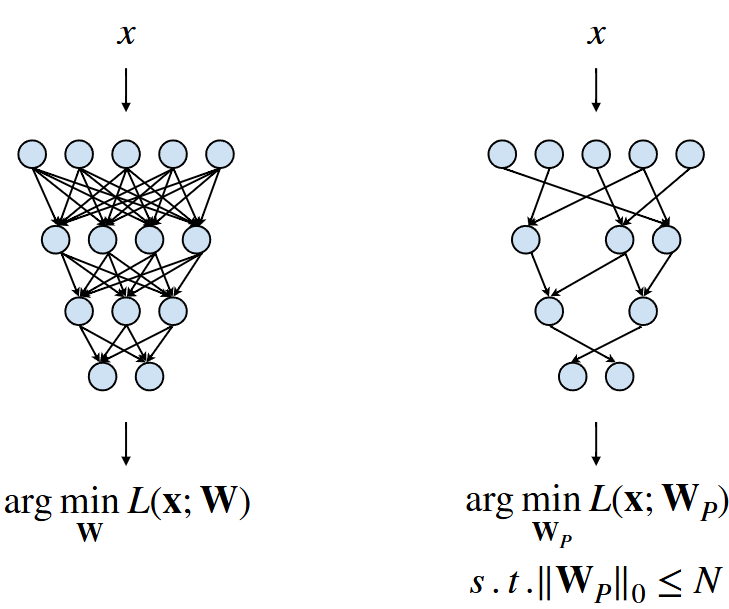 $$
arg_{W}minL(x;W)
$$
(1)式表示,给定输入x,使损失函数L最小的W。
$$
s .t.||W_{P}||_{0}\leq N
$$
(2)式表示,在满足:$W_{P}$的非零元素少于目标的非零元素数量,也就是说,我们设定一个最小剪枝力度。在此基础上调整网络,是损失函数L最小。
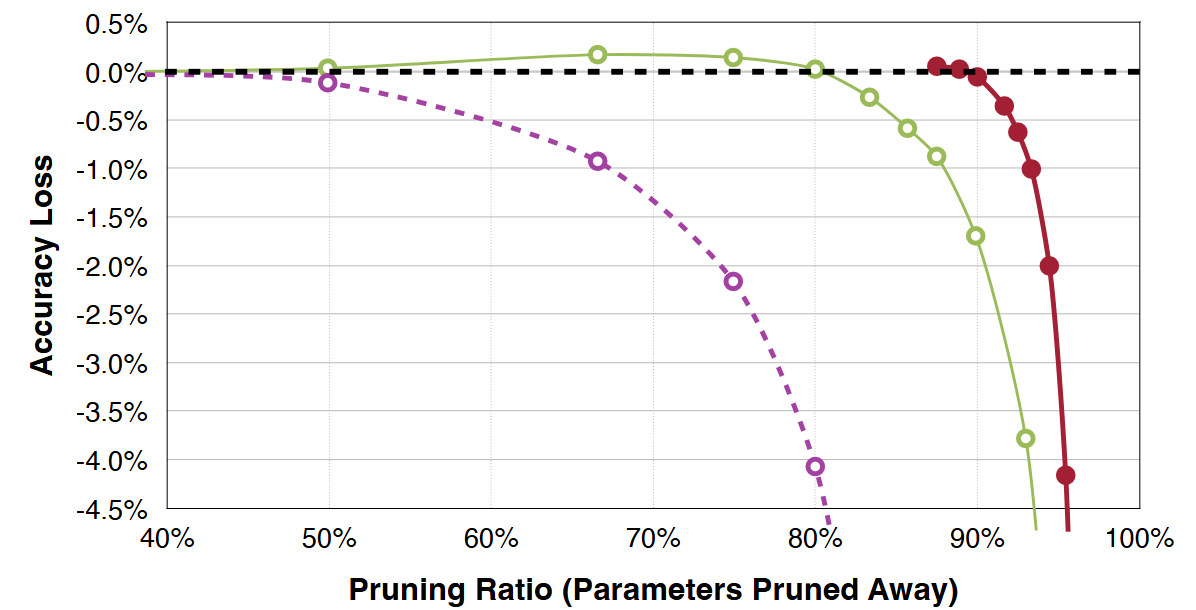
紫色对应纯剪枝,绿色对应剪枝+微调,红色对应剪枝+微调不断迭代。
剪枝粒度的抉择
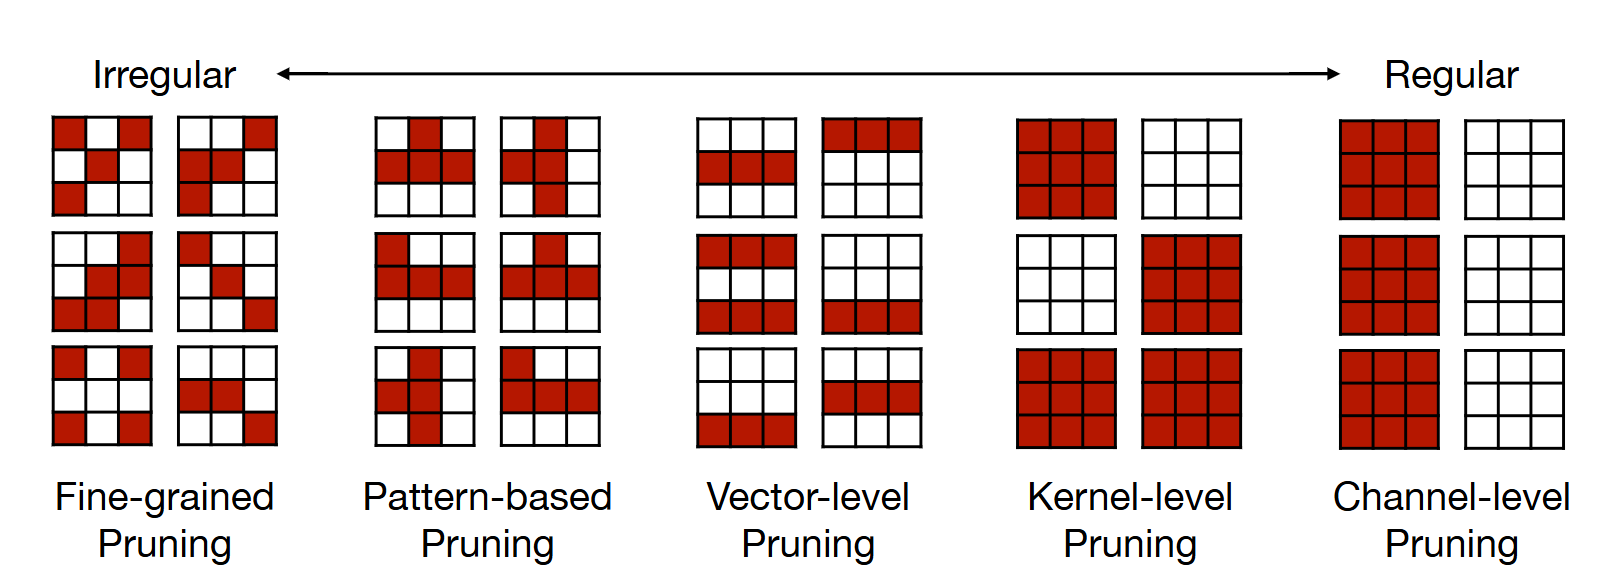
最左边的细粒度剪枝,能实现最大限度的剪枝,优点是灵活,缺点是非结构化导致性能下降,除非有特定的硬件架构实现。
第二种是基于模式的剪枝,极大提高了规律性,例如在每四格数据中剪掉两格。这时你需要2bit作为元数据来索引非零元素。
这边忽略第三第四幅图。现在让我们剪掉整个通道,这时不需要特殊硬件。
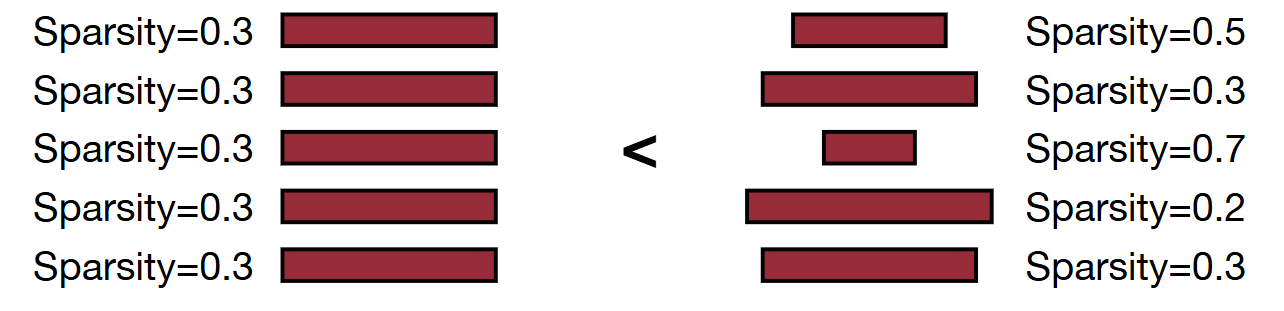
这里展示了两种剪枝方法,使用统一的稀疏度或者为每一层设定单独的稀疏度,显而易见的是后者一定更优。我们可以自动搜索每层稀疏度。
剪枝标准的抉择
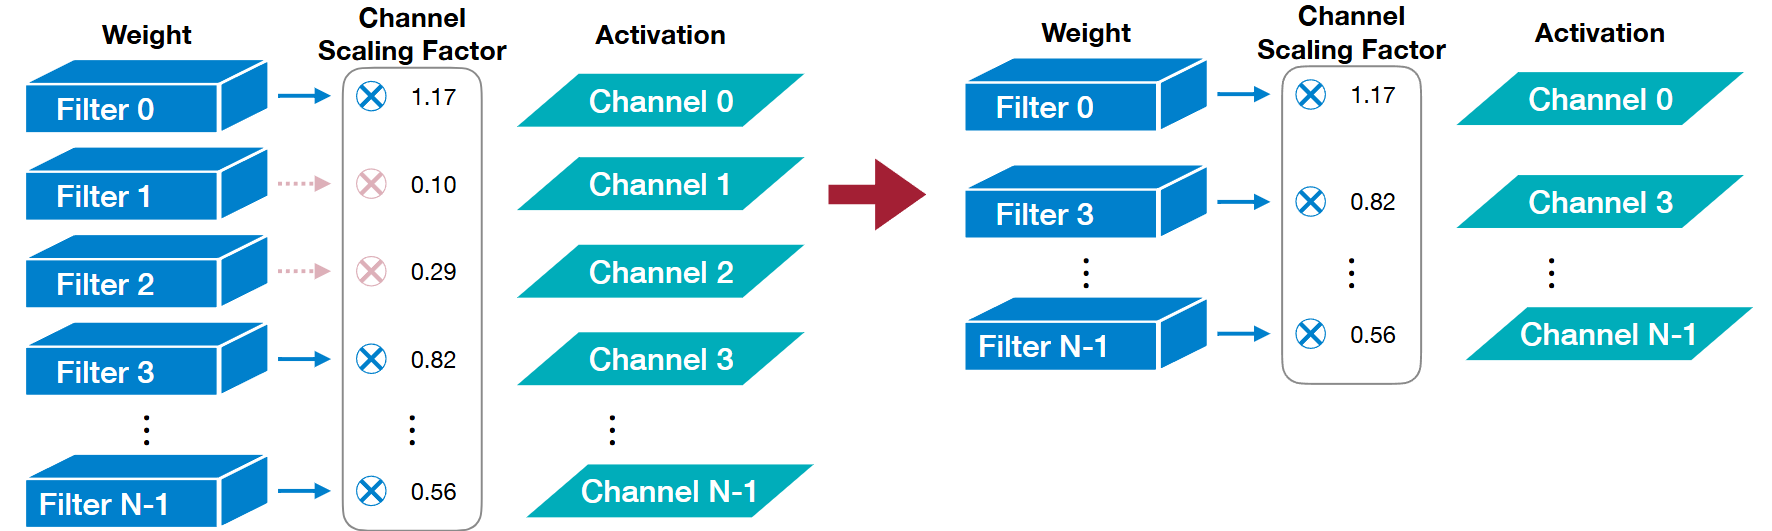
基于缩放的剪枝
从层归一化中获取缩放因子,把缩放因子小的通道剪掉.
基于二阶的剪枝
其中,
我们的目的是让剪枝对原神经网络的影响最小,也就是让最小。此时神经网络的训练已经基本完成,因此第一项为0忽略。根据《最优脑损伤》一文的研究,我们忽略最右边的三阶小量。假设删除每个参数导致的误差是独立的,因此忽略第三项。
可以得到,
是Hessian矩阵的对角元素。Hessian矩阵计算极为困难。
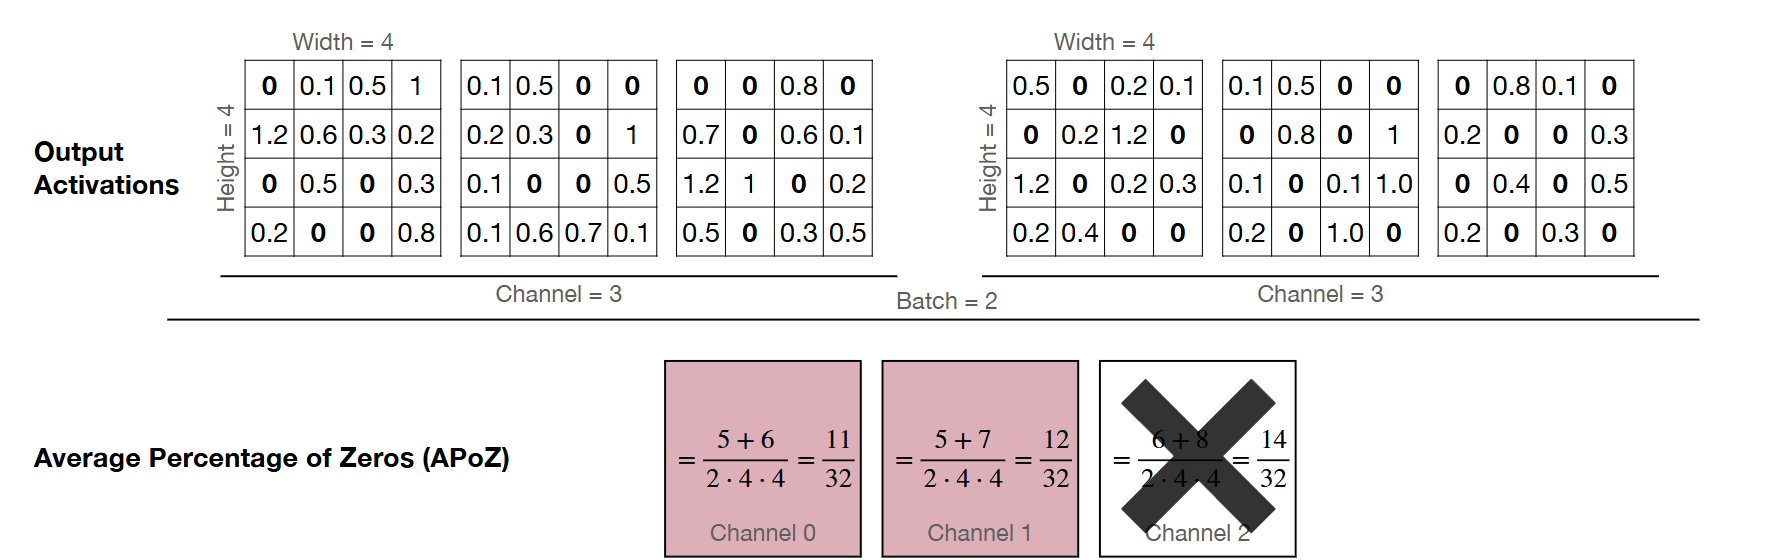
基于零元素占比的激活值剪枝
基于回归的激活值剪枝
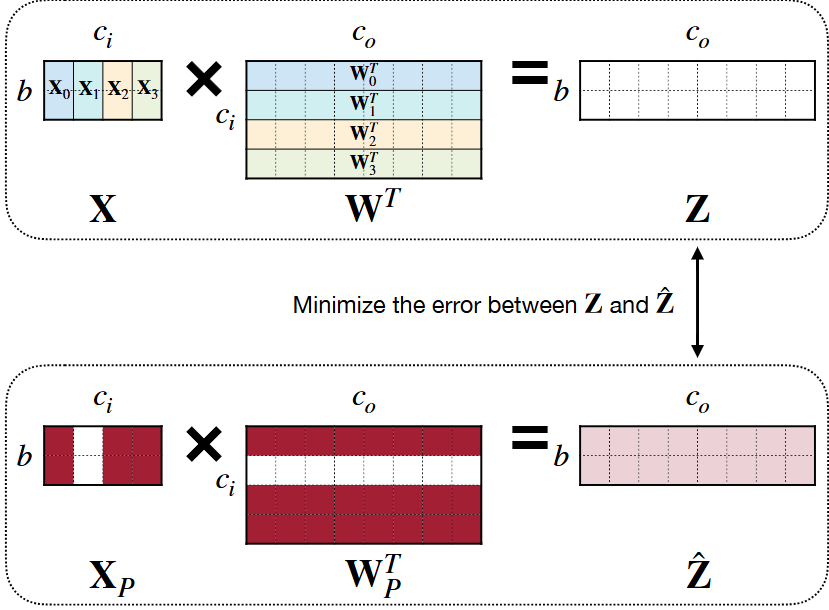 $$
Z = X W^T = \sum_{c=0}^{c_i-1} X_c W_c^T
$$
这里是输出矩阵,是输出矩阵,是权重矩阵,在这里目标是最小化和之间的Frobenius范数误差,表示通道被剪枝。
实施的策略是:
先固定,求解,筛选出最优通道
再固定,求解,最小化误差
剪枝比例的抉择
不同层对剪枝的敏感度是不同的。
AMC
MIT的一位学生开发了AMC,使用经典的强化学习DDPG算法,自动确定每层的剪枝比例。
简单来说就是用Actor网络来预测最佳的剪枝比例,然后Critic网络就会预测对应的误差来评判这个剪枝比例的好坏。
基于规则的剪枝
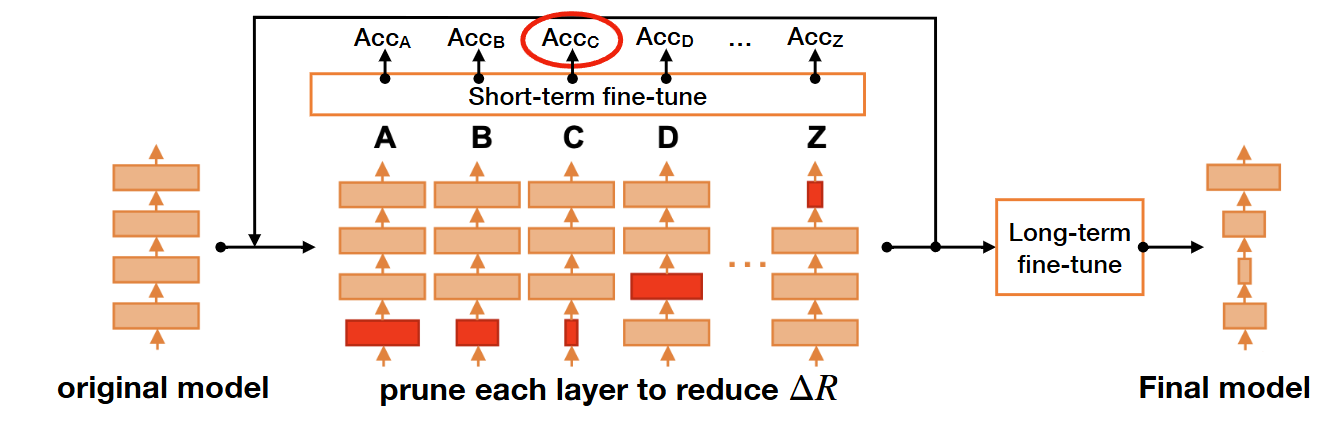
假设每层的剪枝影响是独立的,我们逐层剪枝并微调,不断迭代,最终在给定的下找到精度损失最小的模型,再进行长期微调来加强模型。
训练/微调剪枝神经网络
一般我们采用逐步剪枝的方式,剪枝-微调循环比直接剪枝到目标剪枝比例更好。
训练/微调方面的经验:剪枝时的模型已经基本完成训练,因此我们使用较小的学习率——减小10~100倍。使用正则化有助于鼓励使用更小的参数,下面的两种方式要视情况选择。
稀疏矩阵的并行计算
这一部分参考了Stanford cs149。
稀疏矩阵表示
values = [[3,1],[2],[4],...,[2,6,8]]
cols = [[0,2][1],[2],...]
row_starts = [0,2,3,4,...]
第一个序列很明显记录了非零元素的值,第二个序列记录了每一行 非零元素的列索引,第三个序列记录了每行的第一个非零元素在values中的位置。
稀疏矩阵乘法
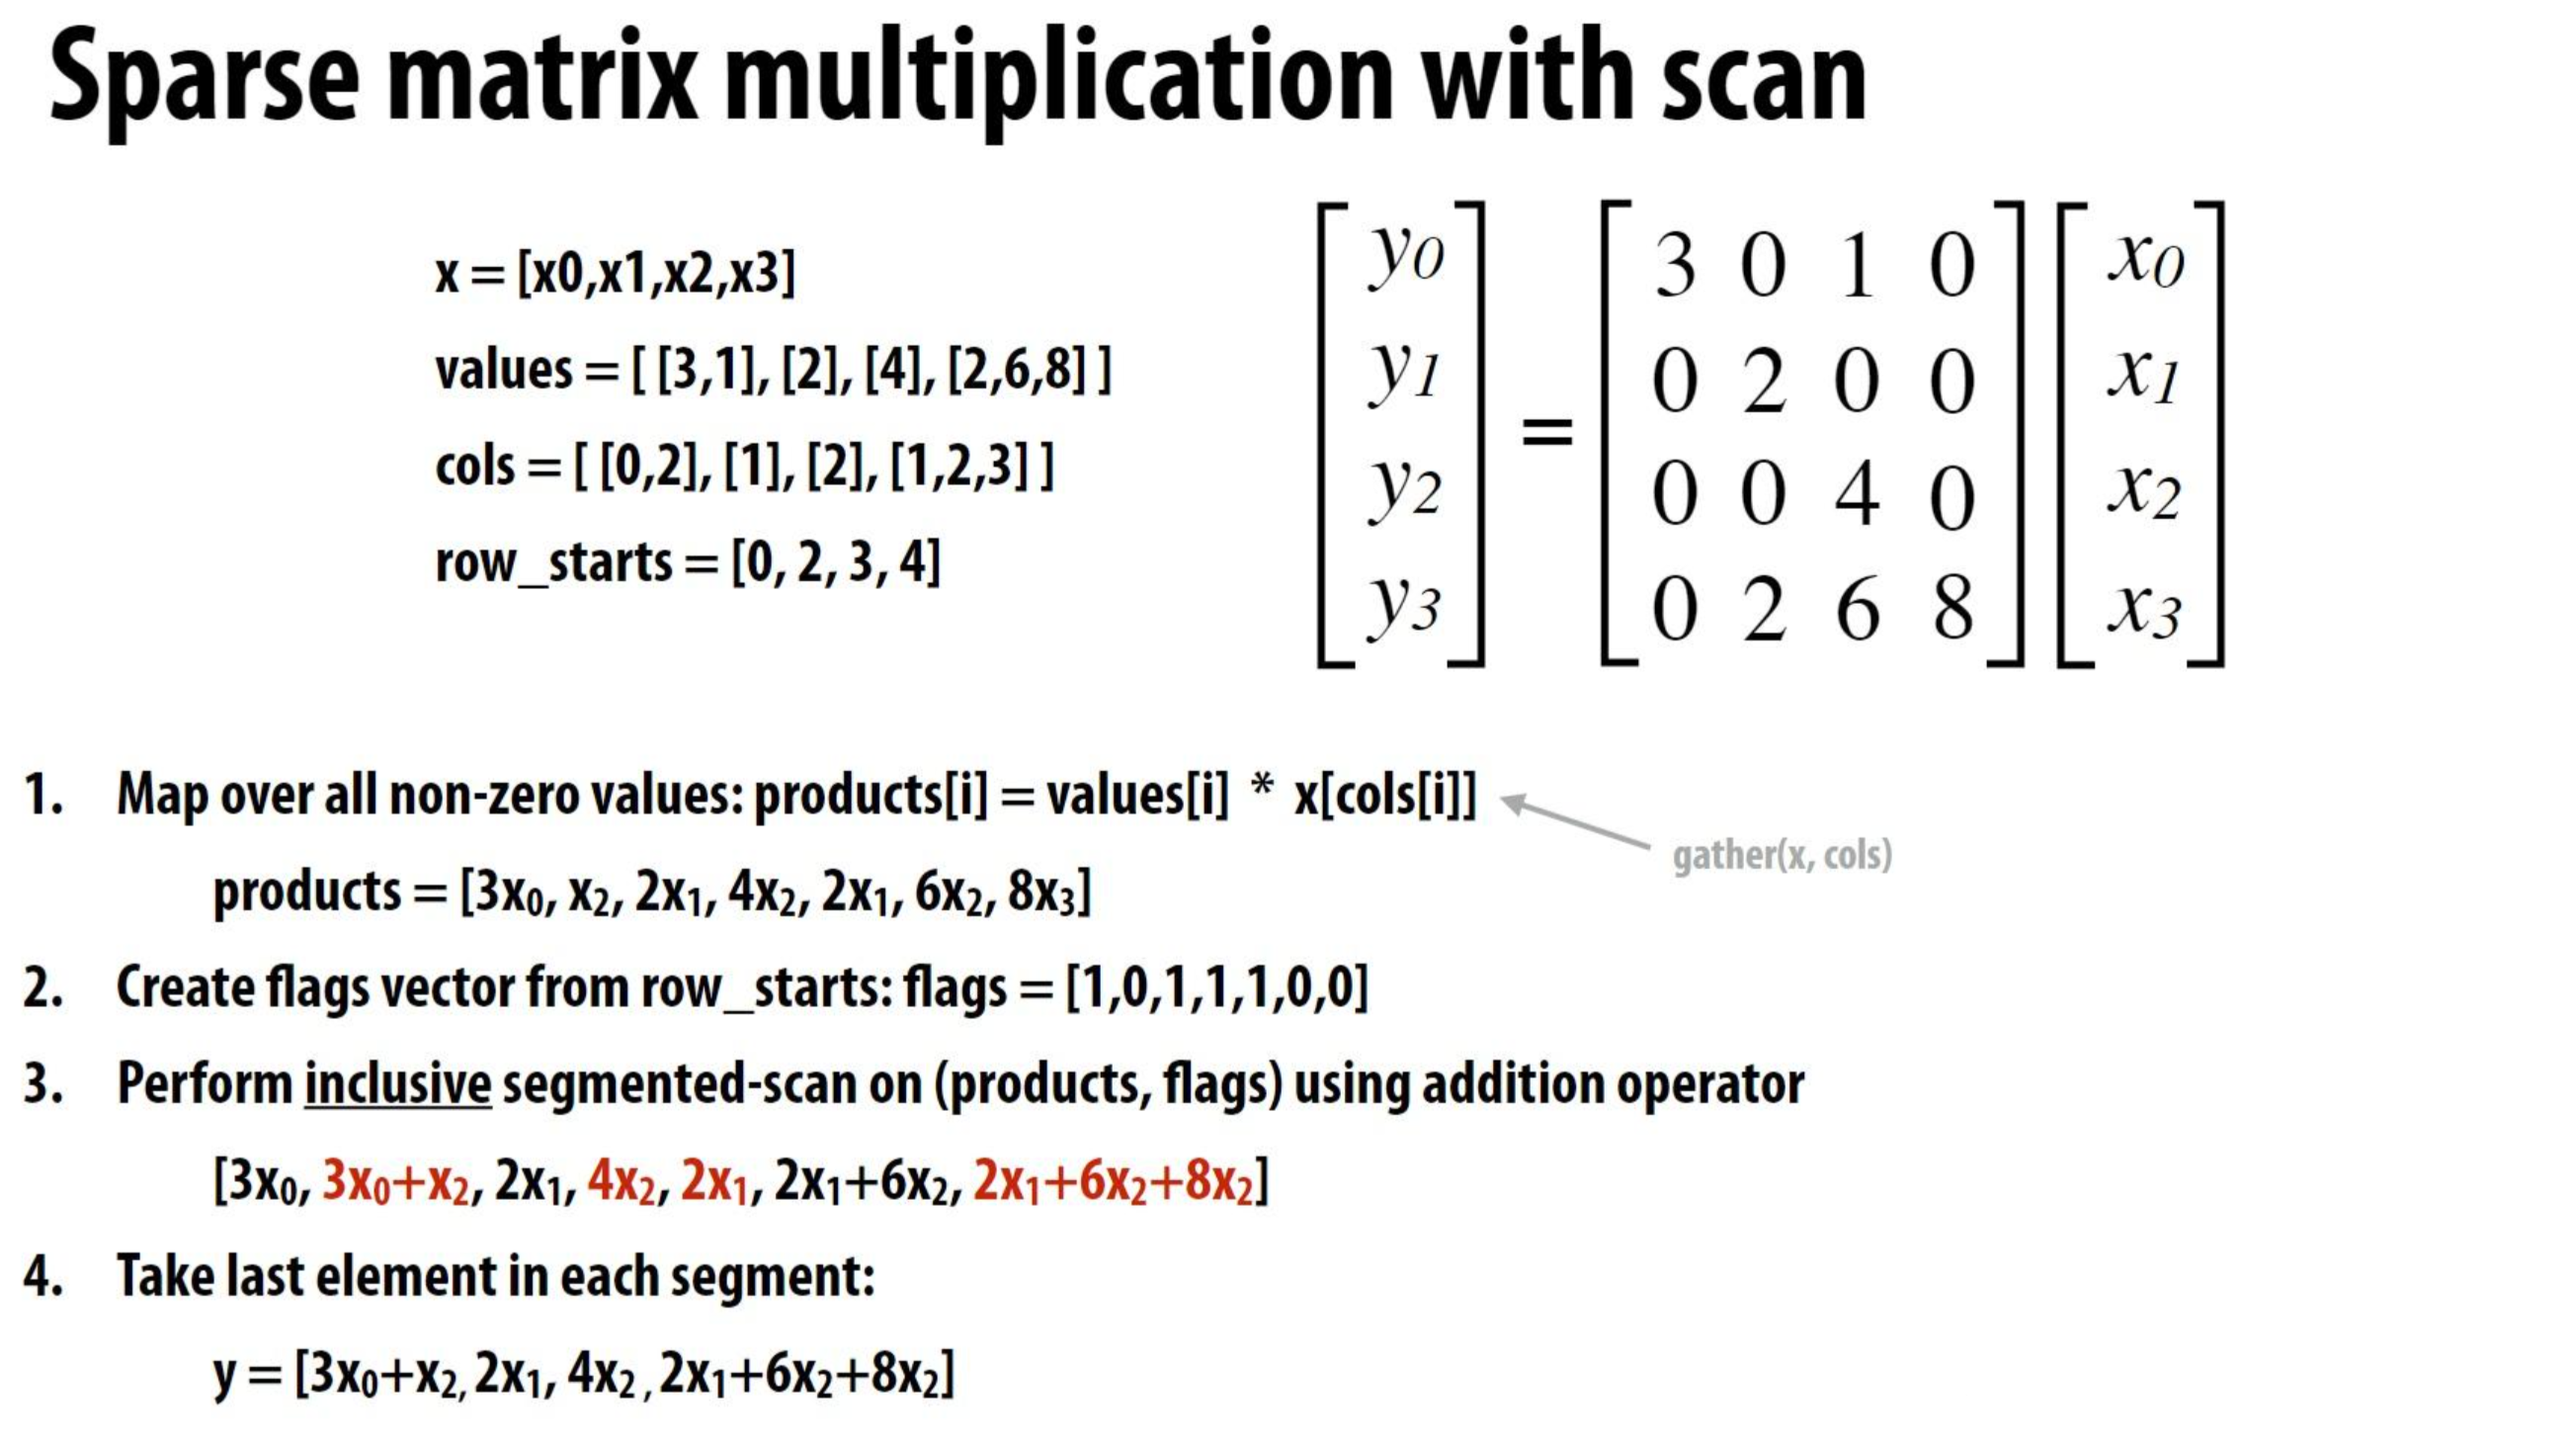
先计算左边矩阵第行和右边矩阵第列的点积,这里使用gather()只对非零元素相乘。第二步把row_starts转换成用1和0表示的位置标志。第三步使用inclusive_scan(),这个操作是计算一个数组的前缀和,即每个元素是该位置之前所有元素的和。
那么有个问题,数据的不规则性会导致row_starts不均匀,这使得下图所示的并行scan()算法效率降低。
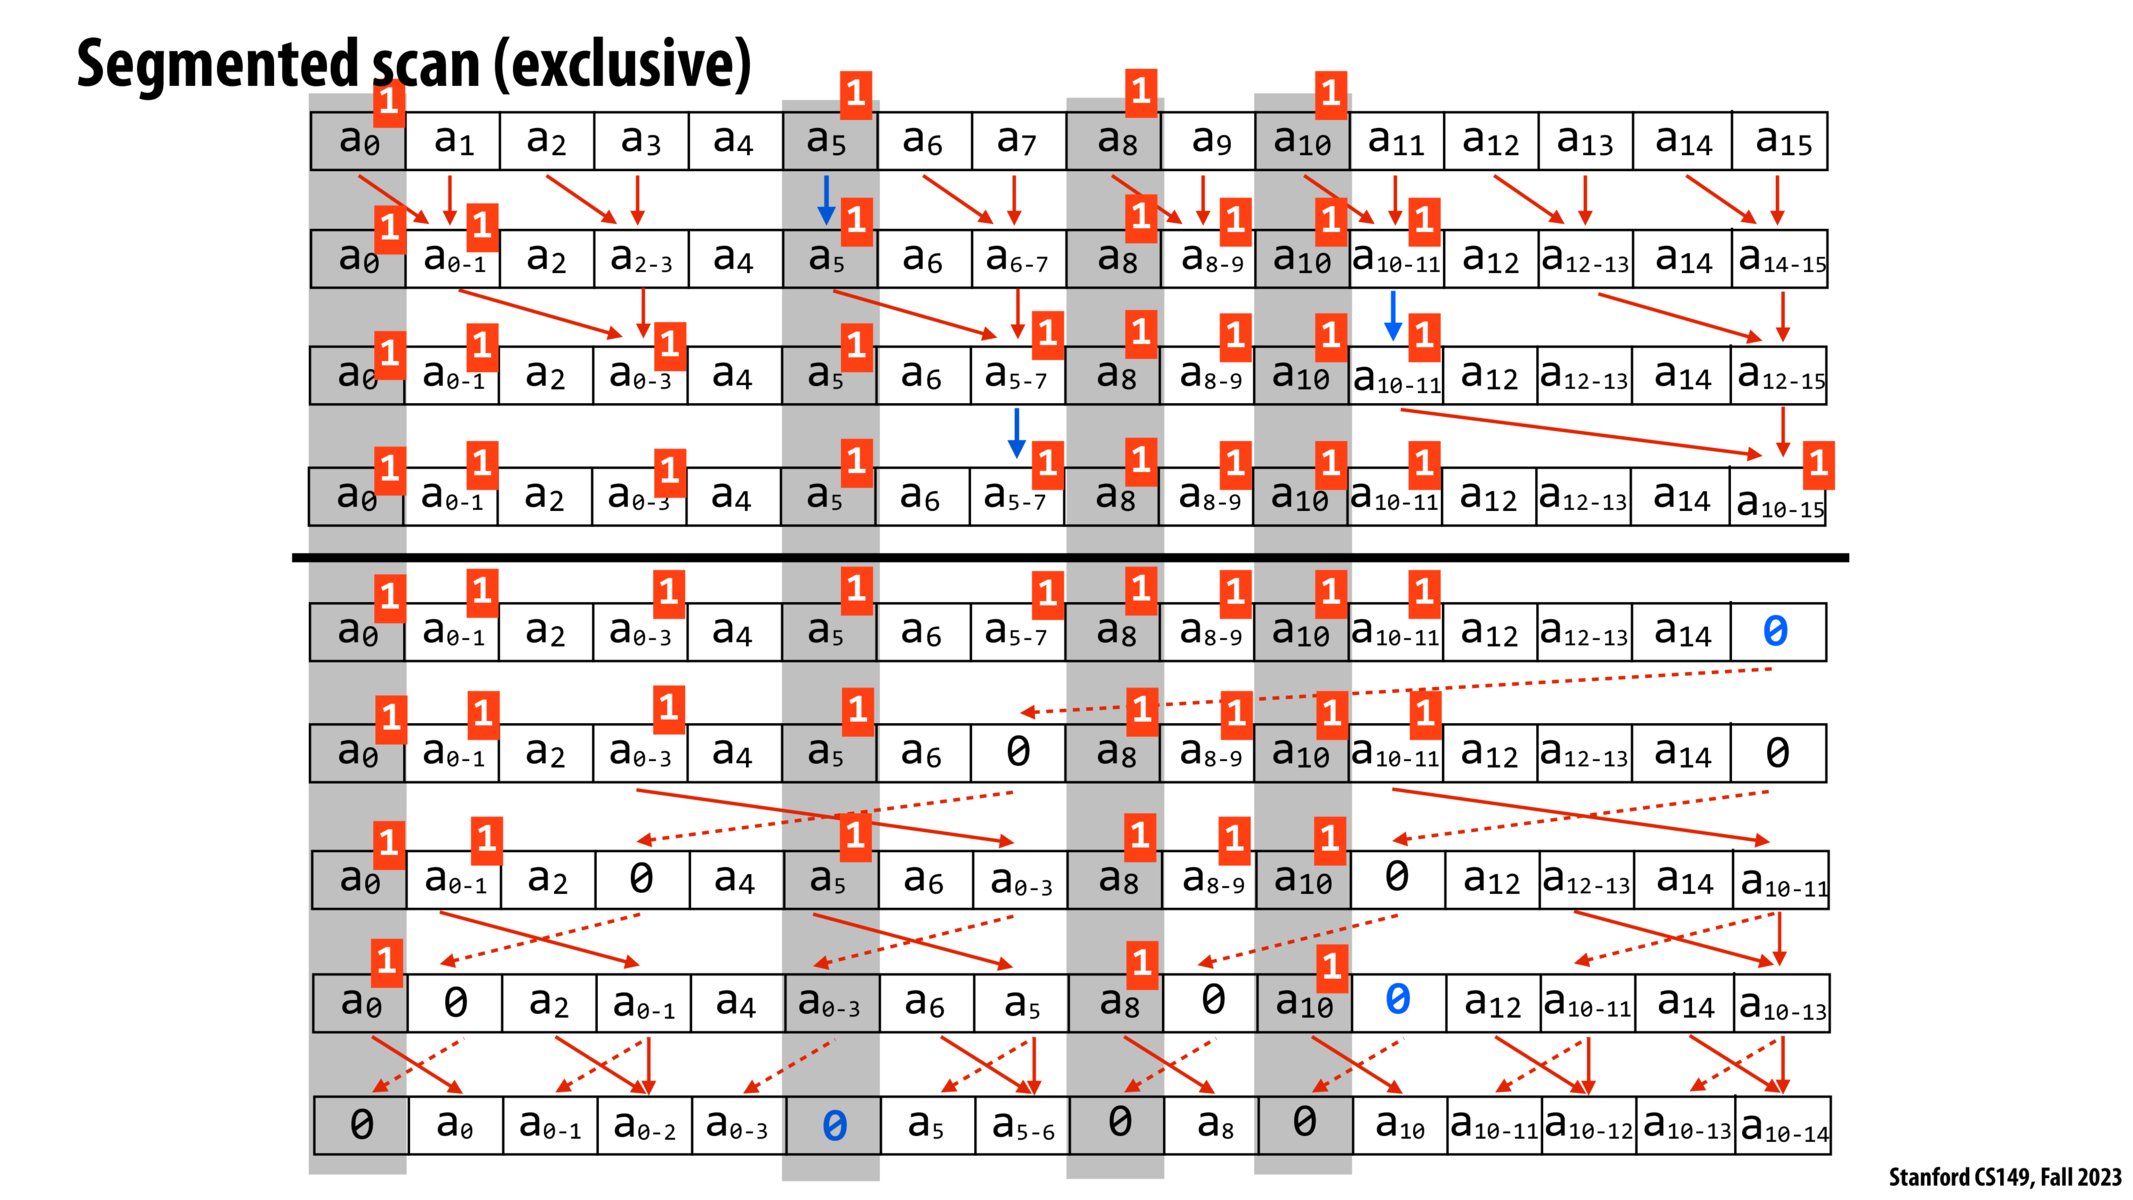
因此我们考虑以下优化办法
- 分组计算
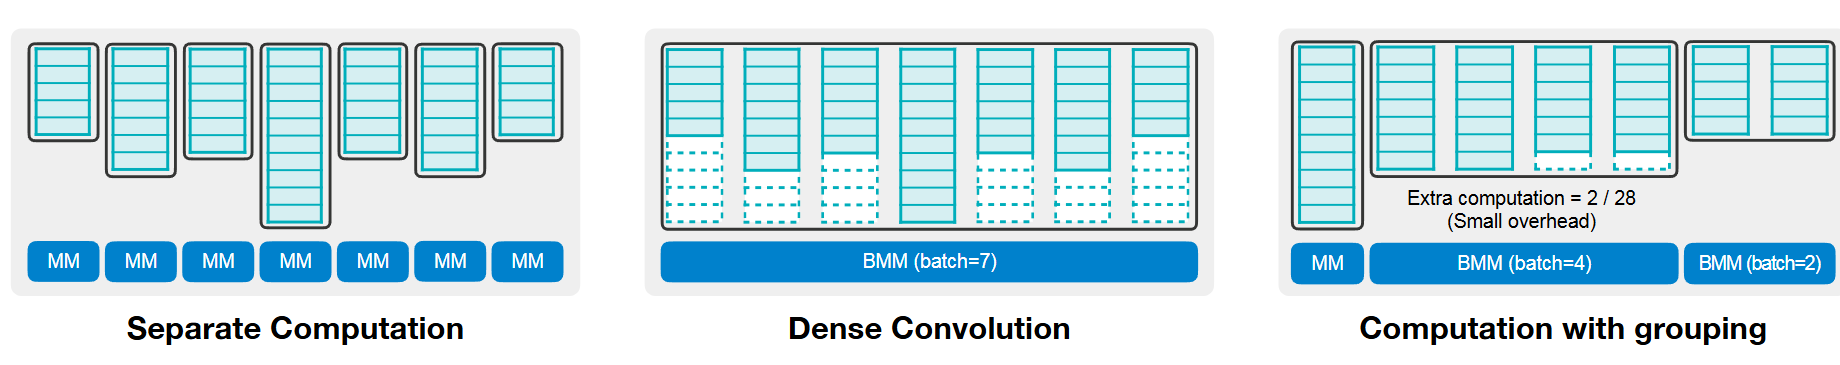
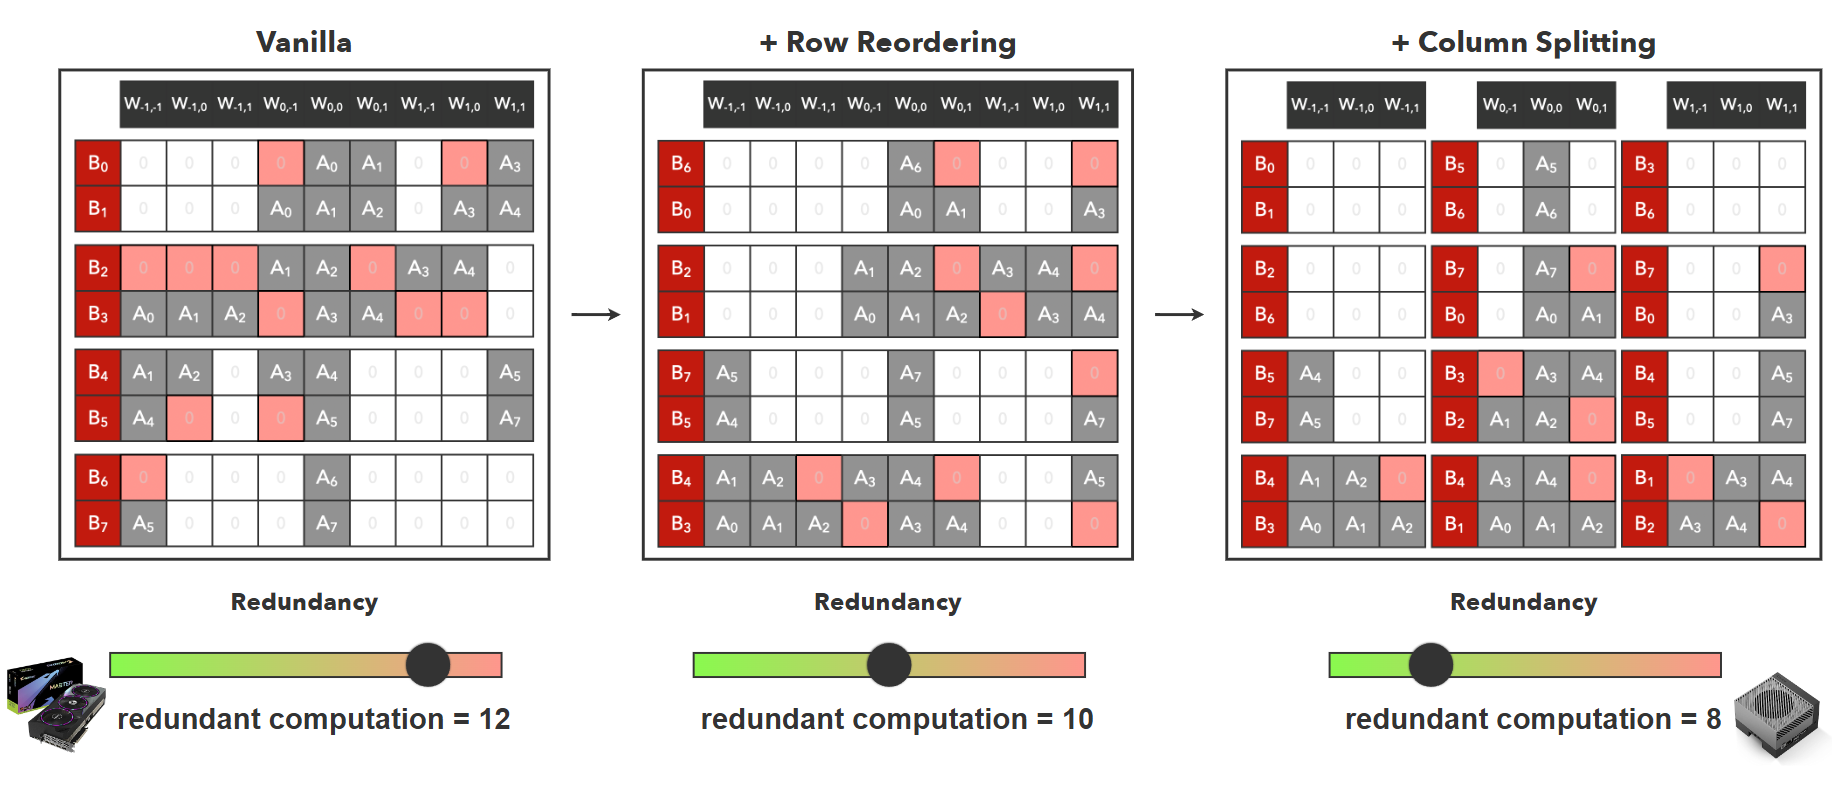
- 行列变换
稀疏卷积算法
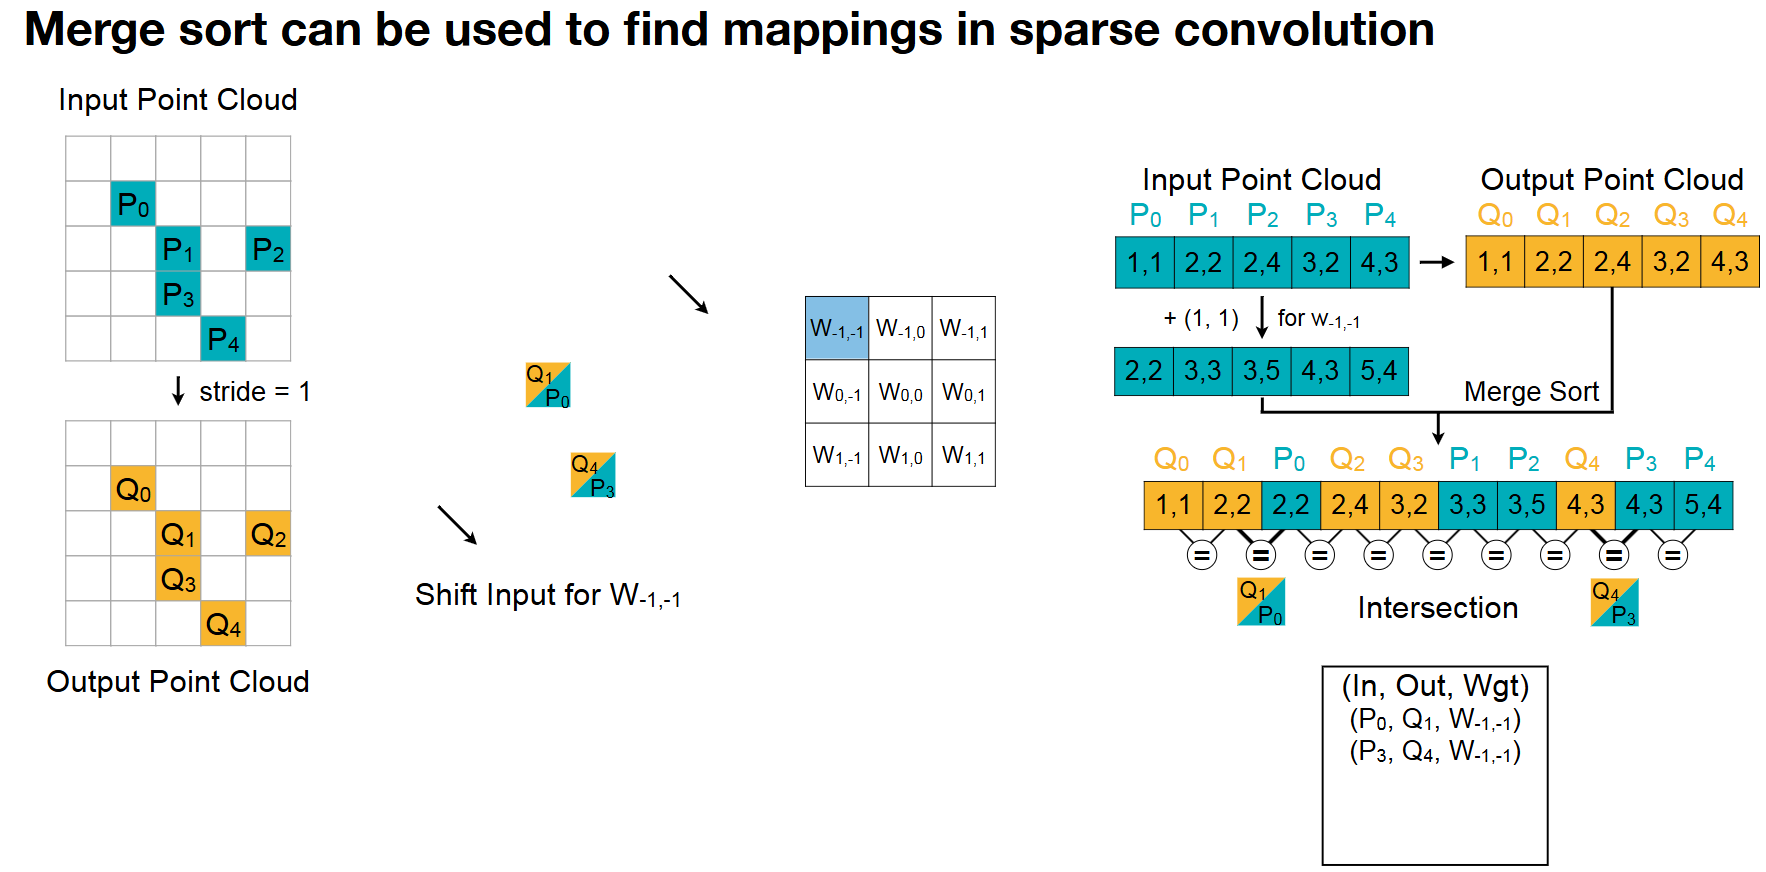
如果给定参数在卷积核的左上角,就将Input矩阵向右下方平移,这很好理解,左上角的参数最终会映射到卷积核中间所在的位置。然后进行排序,把位置相同的像素记录下来,这就是与给定参数有关的输入输出。